يمكن تقسيم مستقبل التعلم العميق إلى نماذج التعلم الثلاثة هذه
يمكن تقسيم مستقبل التعلم العميق إلى نماذج التعلم الثلاثة هذه
التعلم الهجين والمركب والمنخفض

الموقع الأصلي:
التعلم العميق هو مجال واسع ، يتمحور حول خوارزمية يتم تحديد شكلها بملايين أو حتى بلايين المتغيرات ويتم تغييرها باستمرار - الشبكة العصبية. يبدو أنه يتم اقتراح كميات هائلة من الأساليب والتقنيات الجديدة كل يوم.
بشكل عام ، ومع ذلك ، يمكن تقسيم التعلم العميق في العصر الحديث إلى ثلاثة نماذج تعلم أساسية. داخل كل منها يكمن نهج واعتقاد تجاه التعلم الذي يوفر إمكانات واهتمامات كبيرة لزيادة القوة الحالية ونطاق التعلم العميق.
التعلم الهجين - كيف يمكن لطرق التعلم العميق الحديثة عبور الحدود بين التعلم الخاضع للإشراف والتعلم غير الخاضع للإشراف لاستيعاب كمية هائلة من البيانات غير المسماة غير المستخدمة؟
التعلم المركب - كيف يمكن ربط النماذج أو المكونات المختلفة بطرق إبداعية لإنتاج نموذج مركب أكبر من مجموع أجزائه؟
انخفاض التعلم - كيف يمكن تقليل حجم وتدفق المعلومات للنماذج ، سواء لأغراض الأداء والنشر ، مع الحفاظ على نفس القدرة التنبؤية أو قدرة أكبر على التنبؤ؟
يكمن مستقبل التعلم العميق في هذه النماذج الثلاثة للتعلم ، كل منها مترابط بشكل كبير.
التعلم الهجين
يسعى هذا النموذج إلى تجاوز الحدود بين التعلم الخاضع للإشراف والتعلم غير الخاضع للإشراف. غالبًا ما يتم استخدامه في سياق الأعمال بسبب نقص البيانات المصنفة وارتفاع تكلفتها. في جوهره ، التعلم الهجين هو إجابة على السؤال ،
كيف يمكنني استخدام الأساليب الخاضعة للإشراف لحل / بالتزامن مع المشكلات غير الخاضعة للإشراف؟
على سبيل المثال ، يكتسب التعلم شبه الخاضع للإشراف أرضية في مجتمع التعلم الآلي لكونه قادرًا على الأداء الجيد بشكل استثنائي في المشكلات الخاضعة للإشراف مع القليل من البيانات المصنفة. على سبيل المثال ، حققت GAN (شبكة الخصومة التوليدية) المصممة جيدًا شبه الخاضعة للإشراف دقة تزيد عن 90٪ على مجموعة بيانات MNIST بعد رؤيتها فقط 25 أمثلة تدريبية.
تم تصميم التعلم شبه الخاضع للإشراف لمجموعات البيانات حيث يوجد الكثير من البيانات غير الخاضعة للإشراف ولكن كميات صغيرة من البيانات الخاضعة للإشراف. في حين أن نموذج التعلم الخاضع للإشراف يتم تدريبه تقليديًا على جزء واحد من البيانات ونموذج غير خاضع للإشراف على الآخر ، يمكن للنموذج شبه الخاضع للإشراف الجمع بين البيانات المصنفة والرؤى المستخرجة من البيانات غير المسماة.
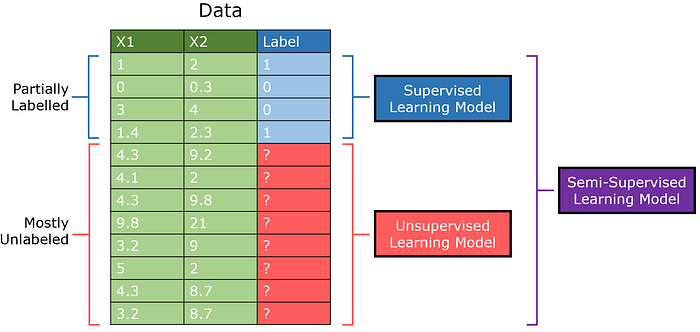
GAN شبه الخاضع للإشراف (يُختصر بـ SGAN) ، هو تعديل للمعيار نموذج شبكة الخصومة التوليدية. يُخرج المُميِّز كلا من 0/1 للإشارة إلى ما إذا كانت الصورة قد تم إنشاؤها أم لا ، ولكن أيضًا ينتج فئة العنصر (التعلم متعدد المخرجات).
يعتمد هذا على فكرة أنه من خلال تعلم أداة التمييز التمييز بين الصور الحقيقية والمولدة ، فهي قادرة على تعلم هياكلها دون تسميات ملموسة. مع التعزيز الإضافي من كمية صغيرة من البيانات المصنفة ، يمكن للنماذج شبه الخاضعة للإشراف تحقيق أفضل أداء بأقل قدر ممكن من البيانات الخاضعة للإشراف.
يمكنك قراءة المزيد عن شبكات SGAN والتعلم شبه الخاضع للإشراف هنا.
تشارك شبكات GAN أيضًا في مجال آخر من التعلم الهجين - الإشراف الذاتي التعلم ، حيث يتم تأطير المشكلات غير الخاضعة للإشراف بشكل صريح على أنها مشكلات خاضعة للإشراف. تنشئ شبكات GAN بيانات خاضعة للإشراف بشكل مصطنع من خلال إدخال مولد ؛ يتم إنشاء الملصقات لتحديد الصور الحقيقية / المُنشأة. من فرضية غير خاضعة للإشراف ، تم إنشاء مهمة خاضعة للإشراف.
بدلاً من ذلك ، ضع في اعتبارك استخدام نماذج التشفير وفك التشفير للضغط. في أبسط أشكالها ، هي عبارة عن شبكات عصبية بها كمية صغيرة من العقد في المنتصف لتمثل نوعًا من الاختناق ، شكل مضغوط. القسمان الموجودان على كلا الجانبين هما جهاز التشفير ووحدة فك التشفير.
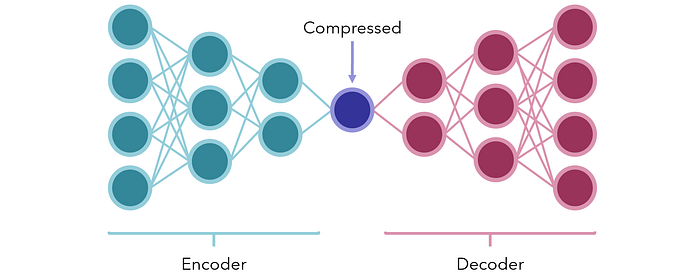
تم تدريب الشبكة على إنتاج نفس الناتج كمدخل متجه (مهمة خاضعة للإشراف تم إنشاؤها بشكل مصطنع من بيانات غير خاضعة للإشراف). نظرًا لوجود عنق الزجاجة المتعمد في الوسط ، لا يمكن للشبكة تمرير المعلومات بشكل سلبي ؛ بدلاً من ذلك ، يجب أن يجد أفضل الطرق للحفاظ على محتوى المدخلات في وحدة صغيرة بحيث يمكن فك تشفيرها بشكل معقول مرة أخرى بواسطة وحدة فك التشفير.
بعد التدريب ، يتم فصل المشفر ووحدة فك التشفير ويمكن استخدامهما على أطراف استقبال البيانات المضغوطة أو المشفرة لنقل المعلومات في شكل صغير للغاية مع القليل من البيانات المفقودة أو معدومة. يمكن استخدامها أيضًا لتقليل أبعاد البيانات.
كمثال آخر ، ضع في اعتبارك مجموعة كبيرة من النصوص (ربما تعليقات من منصة رقمية). من خلال بعض التجمعات أو التعلم المتنوع الطريقة ، يمكننا إنشاء تسميات عنقودية لمجموعات من النصوص ، ثم التعامل معها على أنها تسميات (بشرط أن يكون التجميع جيدًا).
بعد تفسير كل مجموعة (على سبيل المثال ، تمثل المجموعة أ التعليقات التي تشكو من منتج ما ، وتمثل المجموعة ب ردود فعل إيجابية ، وما إلى ذلك) بنية عميقة في معالجة اللغات الطبيعية مثل بيرت يمكن بعد ذلك استخدامها لتصنيف النصوص الجديدة في هذه المجموعات ، وكلها تحتوي على بيانات غير مسماة تمامًا ومشاركة بشرية قليلة.
هذا مرة أخرى تطبيق رائع لتحويل المهام غير الخاضعة للإشراف إلى مهام خاضعة للإشراف. في عصر تكون فيه الغالبية العظمى من جميع البيانات عبارة عن بيانات غير خاضعة للإشراف ، هناك قيمة هائلة وإمكانات هائلة في بناء جسور إبداعية لعبور الحدود بين التعلم الخاضع للإشراف والتعلم غير الخاضع للإشراف مع التعلم الهجين.
التعلم المركب
يسعى التعلم المركب إلى استخدام المعرفة ليس لنموذج واحد ولكن من عدة نماذج. إنه الاعتقاد بأنه من خلال مجموعات أو حقن فريدة للمعلومات - الثابتة والديناميكية - يمكن للتعلم العميق أن يتعمق باستمرار في الفهم والأداء أكثر من نموذج واحد.
يعد التعلم الانتقالي مثالًا واضحًا على التعلم المركب ، وهو مبني على فكرة أنه يمكن استعارة أوزان النموذج من نموذج تم اختباره مسبقًا في مهمة مماثلة ، ثم صقلها وفقًا لمهمة محددة. نماذج مدربة مسبقا مثل نشأه أو VGG-16 مع بنى وأوزان مصممة للتمييز بين عدة فئات مختلفة من الصور.
إذا كنت سأقوم بتدريب شبكة عصبية للتعرف على الحيوانات (القطط والكلاب ، إلخ) ، فلن أقوم بتدريب شبكة عصبية تلافيفية من نقطة الصفر لأن الأمر سيستغرق وقتًا طويلاً لتحقيق نتائج جيدة. بدلاً من ذلك ، كنت سأستخدم نموذجًا تم اختباره مسبقًا مثل Inception ، والذي قام بالفعل بتخزين أساسيات التعرف على الصور ، والتدرب على بضع فترات إضافية على مجموعة البيانات.
وبالمثل ، فإن تضمين الكلمات في الشبكات العصبية NLP ، والتي ترسم كلمات أقرب ماديًا إلى كلمات أخرى في مساحة التضمين اعتمادًا على علاقاتها (على سبيل المثال ، يكون لكل من "تفاحة" و "برتقالي" مسافات أصغر من "تفاحة" و "شاحنة"). يمكن وضع حفلات الزفاف المُحددة مسبقًا مثل GloVe في الشبكات العصبية للبدء من ما هو بالفعل تخطيط فعال للكلمات إلى كيانات عددية وذات مغزى.
أقل وضوحًا ، يمكن أن تحفز المنافسة أيضًا نمو المعرفة. على سبيل المثال ، تقترض شبكات الخصومة التوليدية من نموذج التعلم المركب عن طريق تأليب شبكتين عصبيتين بشكل أساسي ضد بعضهما البعض. هدف المولد هو خداع أداة التمييز ، وهدف أداة التمييز ليس أن يتم خداعها.
سيشار إلى المنافسة بين النماذج باسم "التعلم العدائي" ، ولا يجب الخلط بينه وبين نوع آخر من التعلم العدائي الذي يشير إلى تصميم المدخلات الخبيثة واستغلال حدود القرار الضعيفة في النماذج.
يمكن للتعلم العدائي أن يحفز النماذج ، عادة من أنواع مختلفة ، حيث يمكن تمثيل أداء النموذج فيما يتعلق بأداء الآخرين. لا يزال هناك الكثير من الأبحاث التي يتعين القيام بها في مجال التعلم العدائي ، مع وجود شبكة الخصومة التوليدية باعتبارها الإنشاء البارز الوحيد للحقل الفرعي.
من ناحية أخرى ، يشبه التعلم التنافسي التعلم العدائي ، ولكن يتم إجراؤه على مقياس عقدة تلو الأخرى: تتنافس العقد على حق الاستجابة لمجموعة فرعية من بيانات الإدخال. يتم تنفيذ التعلم التنافسي في "طبقة تنافسية" ، حيث تكون مجموعة الخلايا العصبية كلها متشابهة ، باستثناء بعض الأوزان الموزعة عشوائيًا.
تتم مقارنة كل متجه لوزن الخلايا العصبية مع ناقل الإدخال ويتم تنشيط الخلية العصبية ذات التشابه الأعلى ، العصبون "الفائز يأخذ كل شيء" (الإخراج = 1). الآخرون "معطلون" (الخرج = 0). هذه التقنية غير الخاضعة للرقابة هي مكون أساسي لـ خرائط ذاتية التنظيم و اكتشاف الميزات.
مثال آخر مثير للاهتمام للتعلم المركب هو في بحث العمارة العصبية. بعبارات مبسطة ، تتعلم الشبكة العصبية (عادة ما تكون متكررة) في بيئة التعلم المعززة إنشاء أفضل شبكة عصبية لمجموعة بيانات - تجد الخوارزمية أفضل بنية لك! يمكنك قراءة المزيد عن النظرية هنا والتنفيذ في Python هنا.
تعتبر طرق المجموعات أيضًا عنصرًا أساسيًا في التعلم المركب. لقد أثبتت طرق التجميع العميقة أنها شديدة الأهمية فعال، وزادت شعبية تكديس النماذج من طرف إلى طرف ، مثل أجهزة التشفير وفك التشفير.
يكتشف الكثير من التعلم المركب طرقًا فريدة لبناء روابط بين النماذج المختلفة. إنه يقوم على فكرة أن ،
نموذج واحد ، حتى لو كان كبيرًا جدًا ، يؤدي أداءً أسوأ من عدة نماذج / مكونات صغيرة ، يتم تفويض كل منها للتخصص في جزء من المهمة.
على سبيل المثال ، ضع في اعتبارك مهمة إنشاء روبوت محادثة لمطعم.

يمكننا تقسيمها إلى ثلاثة أجزاء منفصلة: المجاملات / الدردشة ، واسترجاع المعلومات ، والعمل ، وتصميم نموذج للتخصص في كل منها. بدلاً من ذلك ، يمكننا تفويض نموذج فردي لأداء جميع المهام الثلاث.
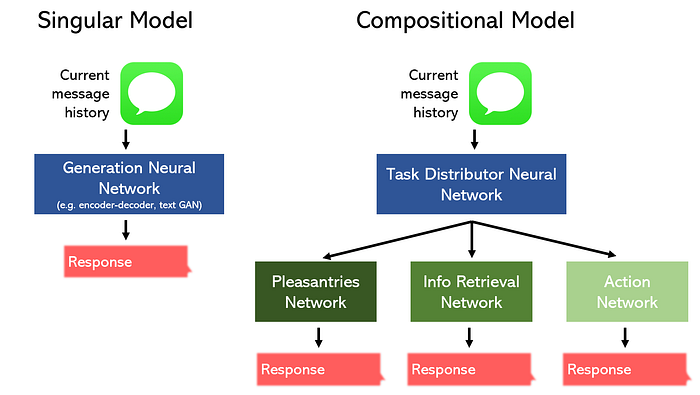
لا ينبغي أن يكون مفاجئًا أن النموذج التركيبي يمكن أن يؤدي بشكل أفضل مع احتلال مساحة أقل. بالإضافة إلى ذلك ، يمكن إنشاء هذه الأنواع من الهياكل غير الخطية بسهولة باستخدام أدوات مثل واجهة برمجة تطبيقات Keras الوظيفية.
من أجل معالجة تنوع متزايد من أنواع البيانات ، مثل مقاطع الفيديو والبيانات ثلاثية الأبعاد ، يجب على الباحثين بناء نماذج تركيبية إبداعية
اقرأ المزيد عن التعلم التركيبي والمستقبل هنا.
انخفاض التعلم
حجم النماذج ، لا سيما في البرمجة اللغوية العصبية - مركز الإثارة المتوترة في أبحاث التعلم العميق - آخذ في الازدياد ، كثيرا. أحدث طراز GPT-3 يحتوي على 175 مليار المعلمات. مقارنتها بـ بيرت يشبه مقارنة كوكب المشتري بالبعوضة (حسنًا ، ليس بالمعنى الحرفي للكلمة). هل مستقبل التعلم العميق أكبر؟
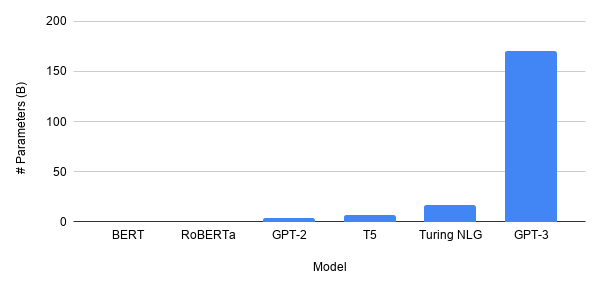
يمكن القول جدا ، لا. من المسلم به أن GPT-3 قوي للغاية ، لكنه أظهر مرارًا وتكرارًا في الماضي أن "العلوم الناجحة" هي العلوم التي لها أكبر تأثير على البشرية. عندما تبتعد الأوساط الأكاديمية كثيرًا عن الواقع ، فإنها عادة ما تتلاشى في الغموض. كان هذا هو الحال عندما تم نسيان الشبكات العصبية في أواخر القرن العشرين لفترة وجيزة من الوقت بسبب قلة البيانات المتاحة لدرجة أن الفكرة ، مهما كانت بارعة ، كانت عديمة الفائدة.
GPT-3 هو نموذج لغة آخر ، ويمكنه كتابة نص مقنع. أين تطبيقاته؟ نعم ، يمكن أن تولد ، على سبيل المثال ، إجابات على استعلام. ومع ذلك ، هناك طرق أكثر فاعلية للقيام بذلك (على سبيل المثال ، اجتياز الرسم البياني للمعرفة واستخدام نموذج أصغر مثل BERT لإخراج إجابة).
لا يبدو الأمر ببساطة أن الحجم الضخم لـ GPT-3 ، ناهيك عن نموذج أكبر ، ممكن أو ضروري نظرًا ل تجفيف من القوة الحسابية.
"قانون مور نوع من النفاد من القوة."
- ساتيا ناديلا، الرئيس التنفيذي لشركة Microsoft
بدلاً من ذلك ، نتجه نحو عالم مدمج بالذكاء الاصطناعي ، حيث يمكن للثلاجة الذكية طلب البقالة تلقائيًا ويمكن للطائرات بدون طيار التنقل في مدن بأكملها بمفردها. يجب أن تكون طرق التعلم الآلي القوية قابلة للتنزيل على أجهزة الكمبيوتر والهواتف المحمولة والرقائق الصغيرة.
هذا يستدعي الذكاء الاصطناعي الخفيف: جعل الشبكات العصبية أصغر مع الحفاظ على الأداء.
اتضح ، بشكل مباشر أو غير مباشر ، أن كل شيء تقريبًا في بحث التعلم العميق له علاقة بتقليل المقدار الضروري من المعلمات ، والذي يسير جنبًا إلى جنب مع تحسين التعميم وبالتالي الأداء. على سبيل المثال ، أدى إدخال الطبقات التلافيفية إلى تقليل عدد المعلمات اللازمة للشبكات العصبية لمعالجة الصور بشكل كبير. تتضمن الطبقات المتكررة فكرة الوقت أثناء استخدام نفس الأوزان ، مما يسمح للشبكات العصبية بمعالجة التسلسلات بشكل أفضل وبأقل معلمات.
يؤدي دمج الطبقات إلى تعيين الكيانات بشكل صريح إلى القيم الرقمية ذات المعاني المادية بحيث لا يتم وضع العبء على معلمات إضافية. في تفسير واحد ، أوقع الطبقات بشكل صريح تمنع المعلمات من العمل على أجزاء معينة من الإدخال. تسوية L1 / L2 يتأكد من أن الشبكة تستخدم جميع معلماتها من خلال التأكد من عدم نمو أي منها بشكل كبير جدًا وأن كل منها يزيد من قيمة معلوماتها.
مع إنشاء طبقات متخصصة ، تتطلب الشبكات معلمات أقل وأقل للبيانات الأكثر تعقيدًا والأكبر. طرق أخرى أكثر حداثة تسعى صراحة لضغط الشبكة.
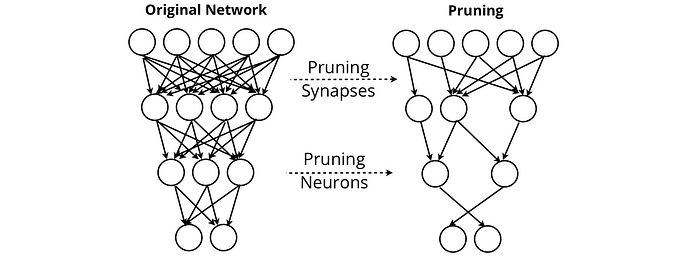
تقليم الشبكة العصبية يسعى لإزالة نقاط الاشتباك العصبي والخلايا العصبية التي لا تقدم قيمة لمخرجات الشبكة. من خلال التقليم ، يمكن للشبكات الحفاظ على أدائها مع إزالة نفسها تقريبًا.
طرق أخرى مثل تقطير معرفة المريض إيجاد طرق لضغط نماذج اللغات الكبيرة في نماذج قابلة للتنزيل على هواتف المستخدمين على سبيل المثال. كان هذا اعتبارًا ضروريًا لـ نظام الترجمة الآلية العصبية من Google (GNMT)، التي تشغل خدمة الترجمة من Google ، والتي كانت بحاجة إلى إنشاء خدمة ترجمة عالية الأداء يمكن الوصول إليها في وضع عدم الاتصال.
في الأساس ، تم تقليل مراكز التعلم حول التصميم المتمحور حول النشر. هذا هو السبب في أن معظم الأبحاث الخاصة بتخفيض التعلم تأتي من قسم الأبحاث في الشركات. يتمثل أحد جوانب التصميم الذي يركز على النشر في عدم اتباع مقاييس الأداء بشكل أعمى في مجموعات البيانات ، ولكن التركيز على المشكلات المحتملة عند نشر نموذج.
على سبيل المثال ، سبق ذكره مدخلات الخصومة هي مدخلات ضارة مصممة لخداع الشبكة. يمكن أن يؤدي رش الطلاء أو الملصقات على اللافتات إلى خداع السيارات ذاتية القيادة لتسريعها بشكل كبير فوق الحد الأقصى للسرعة. جزء من التعلم المنخفض المسؤول لا يقتصر فقط على جعل النماذج خفيفة الوزن بدرجة كافية للاستخدام ، ولكن ضمان قدرتها على استيعاب حالات الزاوية غير الممثلة في مجموعات البيانات.
ربما يحظى التعلم المنخفض بأقل قدر من الاهتمام بالبحث في التعلم العميق ، لأن "تمكنا من تحقيق أداء جيد بحجم معماري مناسب" ليس مثيرًا بقدر "نحقق أداءً متطورًا بهندسة تتكون من من kajillions من المعلمات ".
حتمًا ، عندما يتلاشى السعي وراء نسبة أعلى من النسبة المئوية ، حيث أن تاريخ الابتكار كما هو موضح ، فإن التعلم المنخفض - وهو في الحقيقة مجرد تعلم عملي - سيحظى بقدر أكبر من الاهتمام الذي يستحقه.
ملخص
يسعى التعلم الهجين إلى تجاوز حدود التعلم الخاضع للإشراف وغير الخاضع للإشراف. طرق مثل التعلم شبه الخاضع للإشراف والإشراف الذاتي قادرة على استخلاص رؤى قيمة من البيانات غير المصنفة ، وهو شيء ذو قيمة لا تصدق مع نمو كمية البيانات غير الخاضعة للإشراف بشكل كبير.
نظرًا لأن المهام تصبح أكثر تعقيدًا ، فإن التعلم المركب يفكك مهمة واحدة إلى عدة مكونات أبسط. عندما تعمل هذه المكونات معًا - أو ضد بعضها البعض - تكون النتيجة نموذجًا أكثر قوة.
لم يحظ التعلم المنخفض بالكثير من الاهتمام لأن التعلم العميق يخرج من مرحلة الضجيج ، ولكن سرعان ما سيظهر ما يكفي من التطبيق العملي والتصميم المتمحور حول النشر.
شكرا للقراءة!
البيان: للتبادل الأكاديمي فقط. حقوق نشر هذه المقالة تعود إلى المؤلف الأصلي. إذا كان هناك أي خطأ ، يرجى الاتصال للحذف.